ハイパー久々の更新。
仕事では(というかプライベートでも)一切プログラミングをしないんですが、なんかやるぞ!と急にテンションが上がって、
ずっと興味があったデータ分析コンペのサイト?Kaggleをやろうとなりました。
とりあえず、問題形式の確認から、回答の提出まで。
Atcoderみたいなプログラミングコンテストのサイトとかでも、一番時間がかかるのは「回答するまでの流れをきちんと理解する」ことだったので、まずはそこから確認しました。
案の定、一発では上手くいかず・・・
学生時代に少しだけ使っていたR言語の使い方も思い出しながら、ゆっくりやっていきました。
ちなみにR言語の参考に使ったサイトはコチラの"R-Source"というサイト。学生時代にも見た記憶があります。
基礎的なことがメインで載っているサイトです。
今回提出までやったのはこの問題。
Titanic号の客の生死を推測する問題(例題?)です。
Kaggleは英語で書いてあります。英語で書かないでよ・・・
DashboardのDataのところから、"train.csv"と"test.csv"をダウンロード。
中身を見てみて、どんなデータかを確認。
"test.csv"の形式は、"train.csv"の形式から『Survived』の列を除いたもののようです。
また、提出の形式はここに書いてあるように、
とりあえず"gendermodel.csv"をダウンロードして、まねるようにします。
提出までやるぞ!ってことなので、一番シンプルな回答を出すことに。
生死は1と0で表されるのですが、『すべて0』という回答を提出してみます。
他の言語で書いてもいいんですが、慣れるためにもRで書いてみました。
Make a submissionのページに「CSVファイルで出してね」と書いてあるので、もちろんそれに従います。
 out <- file("./allzero.csv", "w") # 書き込みモードで開く

 writeLines("PassengerId,Survived", out) # この行が必要っぽい
 for (i in 892:1309) {
 	writeLines(paste(i), out, sep = ",")
 	writeLines(paste(0), out, sep = "\n")
 }
 close(out)                        # ファイルを閉じる
このプログラムを、Rで起動させます。
$ R

R version 2.15.3 (2013-03-01) -- "Security Blanket"
Copyright (C) 2013 The R Foundation for Statistical Computing
ISBN 3-900051-07-0
Platform: x86_64-apple-darwin9.8.0/x86_64 (64-bit)

Rは、自由なソフトウェアであり、「完全に無保証」です。
・・・(などと色々書いてある)・・・
'q()'と入力すればRを終了します。

> source("ans.r")
>そして、これで出来た『allzero.csv』はこんな感じです。
PassengerId,Survived
892,0
893,0
894,0
・・・(省略)・・・
1308,0
1309,0
これを提出すると・・・
無事受理されました!(ここまでで何回かつまずいています)
しかしAtcoderとかと異なり、受理されるのは当たり前、その後出る順位が大切・・・。
これの結果は
スコア:0.62679
順位 : 3704位/3754(全体)
でした。
そりゃあそうですよね。こんな雑な推定ないよ。
Rに慣れる意味も込めて色々触り、少しだけ改良して出すことにしました。
いきなりRに入っている色々な統計関数を使っても、あんまり勉強にならない気がしたので。
まず、Rの対話モードで、『train.csv』を色々いじってみます。
*まず、train.csvをyという変数に入れる。そのあと色々する。
> y <- read.table("train.csv", header=T, sep=",")

*mode() は、型を調べる関数です。きっと。
> print(mode(y))
[1] "list"
> print(mode(y[1]))
[1] "list"

> print(y[4])
                                                                                  Name
1                                                              Braund, Mr. Owen Harris
2                                  Cumings, Mrs. John Bradley (Florence Briggs Thayer)
3                                                               Heikkinen, Miss. Laina
・・・(以下省略)

*Rでリストの要素にアクセスするときは1から始まるんですね。
> print(y[5])
       Sex
1     male
2   female
3   female
・・・(以下省略)

*列の名前を使ってアクセス
> print(y["Sex"])
       Sex
1     male
2   female
3   female
・・・(以下省略)

*列で条件をつけて、満たすもののみ表示
> y[y$Sex=="female", ]
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
2,1,1,"Cumings, Mrs. John Bradley (Florence Briggs Thayer)",female,38,1,0,PC 17599,71.2833,C85,C
3,1,3,"Heikkinen, Miss. Laina",female,26,0,0,STON/O2. 3101282,7.925,,S
4,1,1,"Futrelle, Mrs. Jacques Heath (Lily May Peel)",female,35,1,0,113803,53.1,C123,S
・・・(以下省略)

*列で条件をつけて、満たすものの、欲しい列だけ表示。リストで返ってくる。
> y[y$Sex=="female", "Survived"]
  [1] 1 1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 0 1 0 0 1 1 1 0 1 1 1 1 1 1 1 0 1 1 1 1
 [38] 1 1 0 1 1 0 0 0 0 1 1 0 1 1 0 1 1 0 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 0 0 1 1
・・・(省略)・・・
[260] 1 1 0 1 0 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 0 1 0 1 0 0 1 1 1 1 1 1 1 0
[297] 1 0 1 1 1 1 0 1 1 1 1 1 1 1 0 0 1 0

*男女で、生死の割合がどんな感じか調べる。リストに使える関数、lengthとsumを使う。
> fsurvived <- y[y$Sex=="female", "Survived"]
> length(fsurvived)
[1] 314
> sum(fsurvived)
[1] 233
> msurvived <- y[y$Sex=="male", "Survived"]
> length(msurvived)
[1] 577
> sum(msurvived)
[1] 109
*これを見るに、女性は半分以上が1、男性は半分以上が0であるっぽい。

*あとは、要素へのアクセスの仕方を色々触ってみる
> y[1]
    PassengerId
1             1
2             2
3             3
4             4
・・・(以下省略)

> y[1,]
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,"Braund, Mr. Owen Harris",male,22,1,0,A/5 21171,7.25,,S

> y[1,"Survived"]
[1] 0

> length(y[1])
[1] 1

*データの列数
> ncol(y)
[1] 12

*データの行数
> nrow(y)
[1] 891
これらから、『男性は0、女性は1』という回答を作成してみる。
あと、1つ目のプログラムでは、
for (i in 892:1309)
など、ダサい点が残っていたので、その辺も少し直す。
そして書いたのが以下。
traindata <- read.table("train.csv", header=T, sep=",")
testdata <- read.table("test.csv", header=T, sep=",")


 out <- file("./sexans.csv", "w") # 書き込みモードで開く
 writeLines("PassengerId,Survived", out) # ヘッダーを記入

 for (i in 1:nrow(testdata)) {
 	writeLines(paste(testdata[i, "PassengerId"]), out, sep = ",")
 	if(testdata[i, "Sex"] == "male"){
 		writeLines(paste(0), out, sep = "\n")
 	}else{
 		writeLines(paste(1), out, sep = "\n")
 	}
 }
 close(out)                        # ファイルを閉じる
これを提出。無事に受理された。
気になる順位は・・・
スコア:0.76555 (0.13876アップ!)
3109位/3754(全体) ( 約600位アップ!)
おお、少し上がっている・・・
ちなみに、
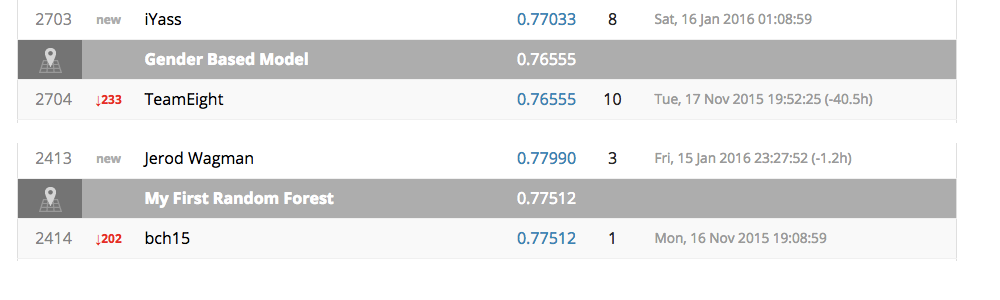
こんな感じで、『こういう手法ならこのスコアだよ』みたいなのが、順位のところの合間にあります。
実際、僕のスコアは、『Gender Based Model』(男=0、女=1の回答)のスコアと完全に一致しています。
これらのスコアは、勉強する上でのモチベーションになりそうですね。
というわけで、本当に触りの部分、『サイトへのアクセスから提出まで』をやってみました。
先は遠いですが、一個の問題にじっくり取り組んでいくのもまた面白そうですね。続けるかどうかは別ですが・・・
仕事後の体力(というよるやる気)次第ですね。
また、これからやる上で、R言語でやっていくのかどうかも迷うところです。
Amazon
今回の問題のホームにも『Predict survival on the Titanic using Excel, Python, R & Random Forests』と書いてあったので、
やっぱこの3つが主流と見てよさそうですね。
*今回の『R言語』(Rの使い方以外に、Rを使いながら統計を理解するが趣旨の本も多い)


*Python(計算ライブラリが豊富で、統計にも強いらしい。
よって、ライブラリも上手く使いこなすぜ的な本が多いっぽい)


*Excel(表紙がキャッチーなのが多い。緑色が多い)


この3つのどれかでやっていくとして、どれにするか・・・
せっかく多少なりともプログラミングに馴染みがあるので、RかPythonかな・・・?
でも、個人的にMicroSoftがなんとなく好きなんですよね。
Xboxを出しているという点で。Xbox持ってないけど。
あと、会社(非IT)ではExcelをよく使うので、単純にExcelに慣れるという意味では、これもExcelでやるのがいいのか・・・?
でも、Excelのデータ分析でハイレベルな本は少なそう・・・?
まぁどれでやっても、『データ分析の勉強』にはなると思うので、あれこれ手を出しながらやるかもしれません。
ひとまず、RかPythonでしょうか。
とにかく、これからも、やる気が続きますように・・・
